6 dk okuma
Giriş
SQL Server performans problemlerinde en sık yapılan hata, sorguyu görür görmez indeks eklemeye çalışmak. Oysa yavaşlığın nedeni kötü bir execution plan, gereksiz veri okuma, güncel olmayan istatistikler, parameter sniffing, hatalı join sırası veya uygulamanın yaptığı fazla sayıda çağrı olabilir.
SQL Server sorgu optimizasyonu için en sağlıklı yaklaşım önce ölçmek, sonra execution plan üzerinden darboğazı anlamak ve yalnızca ihtiyaç varsa indeks veya sorgu değişikliği yapmaktır. Böylece sorunu geçici olarak gizlemek yerine gerçek nedenini çözebilirsiniz.
Yavaş sorgu tespiti, execution plan, Query Store, DMV ve before/after performans ölçümlerini çalışan SQL Server laboratuvarında inceleyebilirsiniz.
GitHub Projesini İncele →1. Önce yavaşlığı ölçün
Bir sorgunun 'yavaş' olduğunu söylemeden önce ne kadar CPU kullandığını, kaç sayfa okuduğunu ve ne kadar sürdüğünü bilmek gerekir. Geliştirme ortamında SET STATISTICS IO ve SET STATISTICS TIME çıktıları oldukça değerlidir.
Sadece toplam süreye bakmak yanıltıcı olabilir. Sorgu önbellekten çalıştığında hızlı, soğuk cache ile çalıştığında yavaş olabilir. Ayrıca uygulama tarafındaki network veya serialization süresi SQL tarafındaki süreyle karıştırılmamalıdır.
Ölçümü birkaç farklı parametreyle yapmak, sorgunun veri dağılımına karşı davranışını anlamayı kolaylaştırır.
2. Estimated Plan yerine Actual Execution Plan'ı da inceleyin
Estimated Execution Plan sorguyu çalıştırmadan optimizer'ın tahmin ettiği planı gösterir. Actual Execution Plan ise çalışma bittikten sonra gerçek satır sayıları, runtime uyarıları ve bazı kaynak kullanım bilgilerini içerir.
Tahmini satır sayısı ile gerçek satır sayısı arasında büyük fark varsa istatistik veya cardinality tahmini tarafında sorun olabilir. Bu fark yanlış join seçimine, gereksiz memory grant'e veya scan yapılmasına yol açabilir.
Bu yüzden yalnızca plan üzerindeki yüzde maliyetlerine bakmak yerine operator özelliklerini ve estimated/actual row farklarını incelemek gerekir.
3. SARGable sorgular yazın
Bir indeksin var olması, sorgunun o indeksi kullanabileceği anlamına gelmez. WHERE içinde indeksli kolona fonksiyon uygulamak, implicit conversion oluşturmak veya wildcard'ı ifadenin başında kullanmak optimizer'ın index seek yapmasını engelleyebilir.
Örneğin WHERE YEAR(OrderDate)=2026 yerine tarih aralığı kullanmak genellikle daha SARGable bir yapıdır. Aynı şekilde veri tiplerini parametre ve kolon tarafında eşleştirmek gereksiz dönüşümleri önler.
SARGable tasarım özellikle büyük tablolarda okunan sayfa sayısını ciddi biçimde azaltabilir.
4. İndeks eklemeden önce workload'u düşünün
Microsoft'un indeks tasarım rehberi, indeksleri spekülatif olarak eklemek yerine gerçek sorgu yüküne göre değerlendirmeyi öneriyor. Her indeks SELECT performansını artırabilir ama INSERT, UPDATE ve DELETE maliyetini de yükseltir.
WHERE ve JOIN koşullarında sık kullanılan kolonlar iyi adaylardır. INCLUDE kolonları bazı sorguları covering index haline getirebilir. Belirli bir alt kümeyi hedefleyen sorgularda filtered index daha küçük ve daha verimli olabilir.
Ancak aynı kolonları içeren çok sayıda benzer indeks zamanla bakım maliyetini artırır. Kullanılmayan indeksleri DMV'ler üzerinden izlemek önemlidir.
5. SELECT * alışkanlığından kaçının
Uygulamanın gerçekten ihtiyaç duymadığı kolonları çekmek disk IO, network trafiği ve memory kullanımını artırır. Özellikle geniş tablolarda SELECT * kullanımı planın covering index avantajını kaybetmesine neden olabilir.
DTO veya projection yaklaşımıyla yalnızca gerekli kolonları almak hem sorgu planını hem uygulama tarafındaki veri taşıma maliyetini iyileştirir. Bu yaklaşım Entity Framework Core sorgularında da önemlidir.
6. Query Store ile geçmişi görün
Bazı performans sorunları her zaman tekrar üretilemez. Sorgu dün hızlıyken bugün yavaşlayabilir. SQL Server Query Store, sorguların zaman içindeki execution plan ve runtime geçmişini tutarak regresyonları analiz etmeyi kolaylaştırır.
Plan değişikliği sonrasında performans bozulduysa önceki iyi plan ile yeni plan karşılaştırılabilir. Gerekli durumlarda plan forcing geçici veya operasyonel bir çözüm sağlayabilir.
Query Store özellikle canlı sistemlerde 'ne değişti?' sorusuna cevap vermek için çok değerlidir.
7. Stored procedure'lerde parametre davranışını test edin
Aynı stored procedure farklı parametrelerle tamamen farklı veri miktarları döndürebilir. İlk compile sırasında oluşan plan sonraki tüm çağrılar için uygun olmayabilir.
Bu durumda doğrudan RECOMPILE eklemek yerine veri dağılımını, istatistikleri ve sorgu tasarımını incelemek daha doğrudur. Bazı senaryolarda farklı sorgu yolları veya dinamik SQL daha sağlıklı olabilir.
Amaç optimizer'ı körlemesine zorlamak değil, doğru bilgiyle iyi plan üretmesini sağlamaktır.
8. Optimizasyondan sonra tekrar ölçün
Bir değişikliğin başarılı olup olmadığını yalnızca sorgunun 'daha hızlı hissettirmesiyle' değerlendirmeyin. Aynı parametre setiyle logical reads, CPU, elapsed time ve actual plan karşılaştırması yapın.
Ayrıca tek sorguyu hızlandırırken sistemin geneline zarar vermediğinizden emin olun. Çok geniş bir indeks bir sorguyu hızlandırıp yüksek yazma trafiği olan tabloda genel performansı düşürebilir.
İyi SQL Server sorgu optimizasyonu lokal değil, workload seviyesinde düşünmeyi gerektirir.
Sonuç
SQL Server performansını iyileştirmek için sihirli bir indeks listesi yok. En iyi sonuç; ölçüm, execution plan analizi, doğru indeks tasarımı, SARGable sorgular ve Query Store gibi izleme araçlarının birlikte kullanılmasıyla elde edilir.
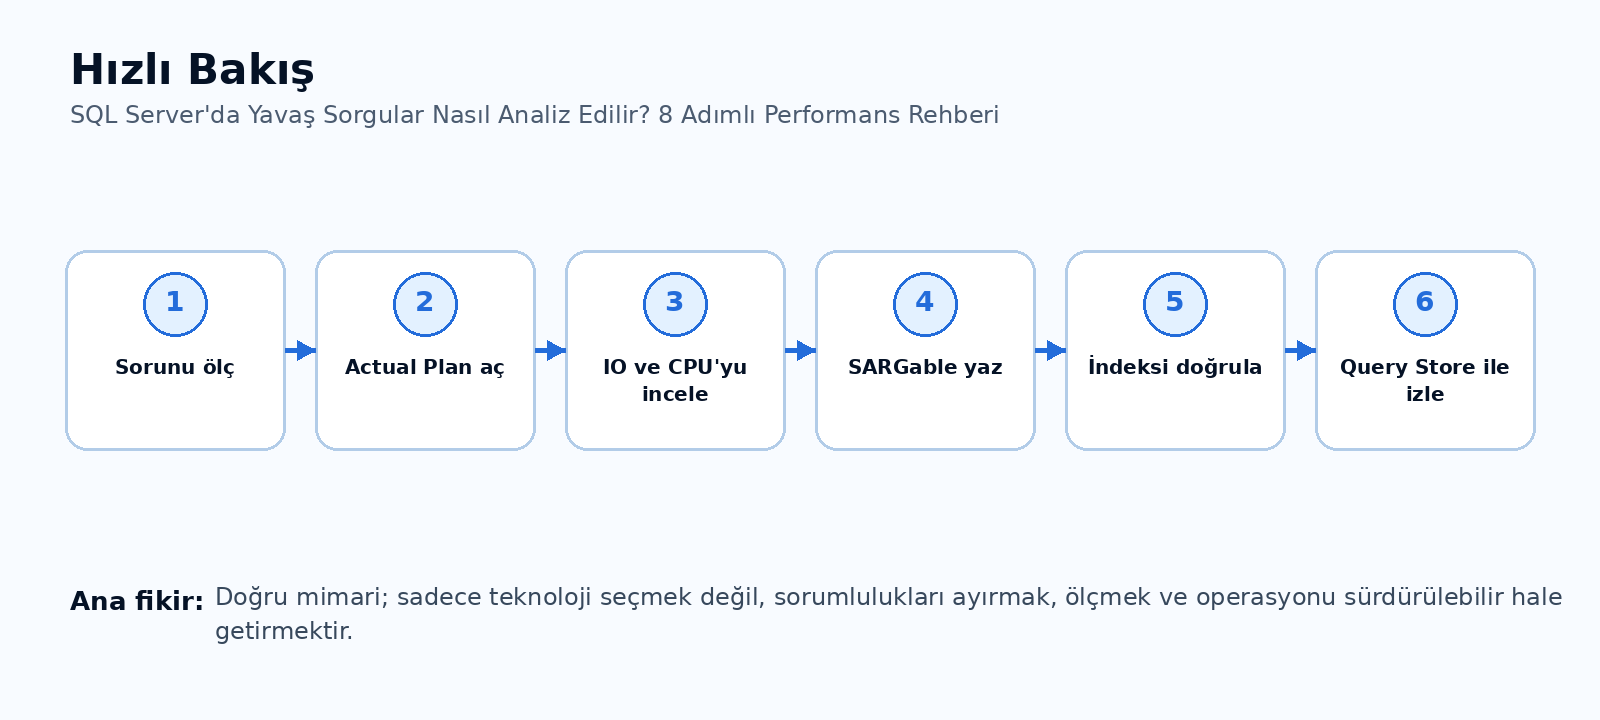
Sorunu sistematik olarak analiz ettiğinizde hem geçici çözümlerden kaçınır hem de aynı tip performans problemlerini ileride çok daha hızlı teşhis edebilirsiniz.