9 dk okuma
Giriş
.NET RAG mimarisi, büyük dil modelini kuruma ait güncel bilgiyle buluştururken yanıtın hangi kaynağa dayandığını da görünür kılar. Ancak üretim kalitesi, birkaç belgeyi vektör veritabanına atıp en yakın üç parçayı modele göndermekten ibaret değildir. Belgenin nasıl ayrıştırıldığı, parçaların hangi metaveriyle saklandığı, sorgunun nasıl filtrelendiği ve cevabın hangi ölçütlerle değerlendirildiği birlikte tasarlanmalıdır.
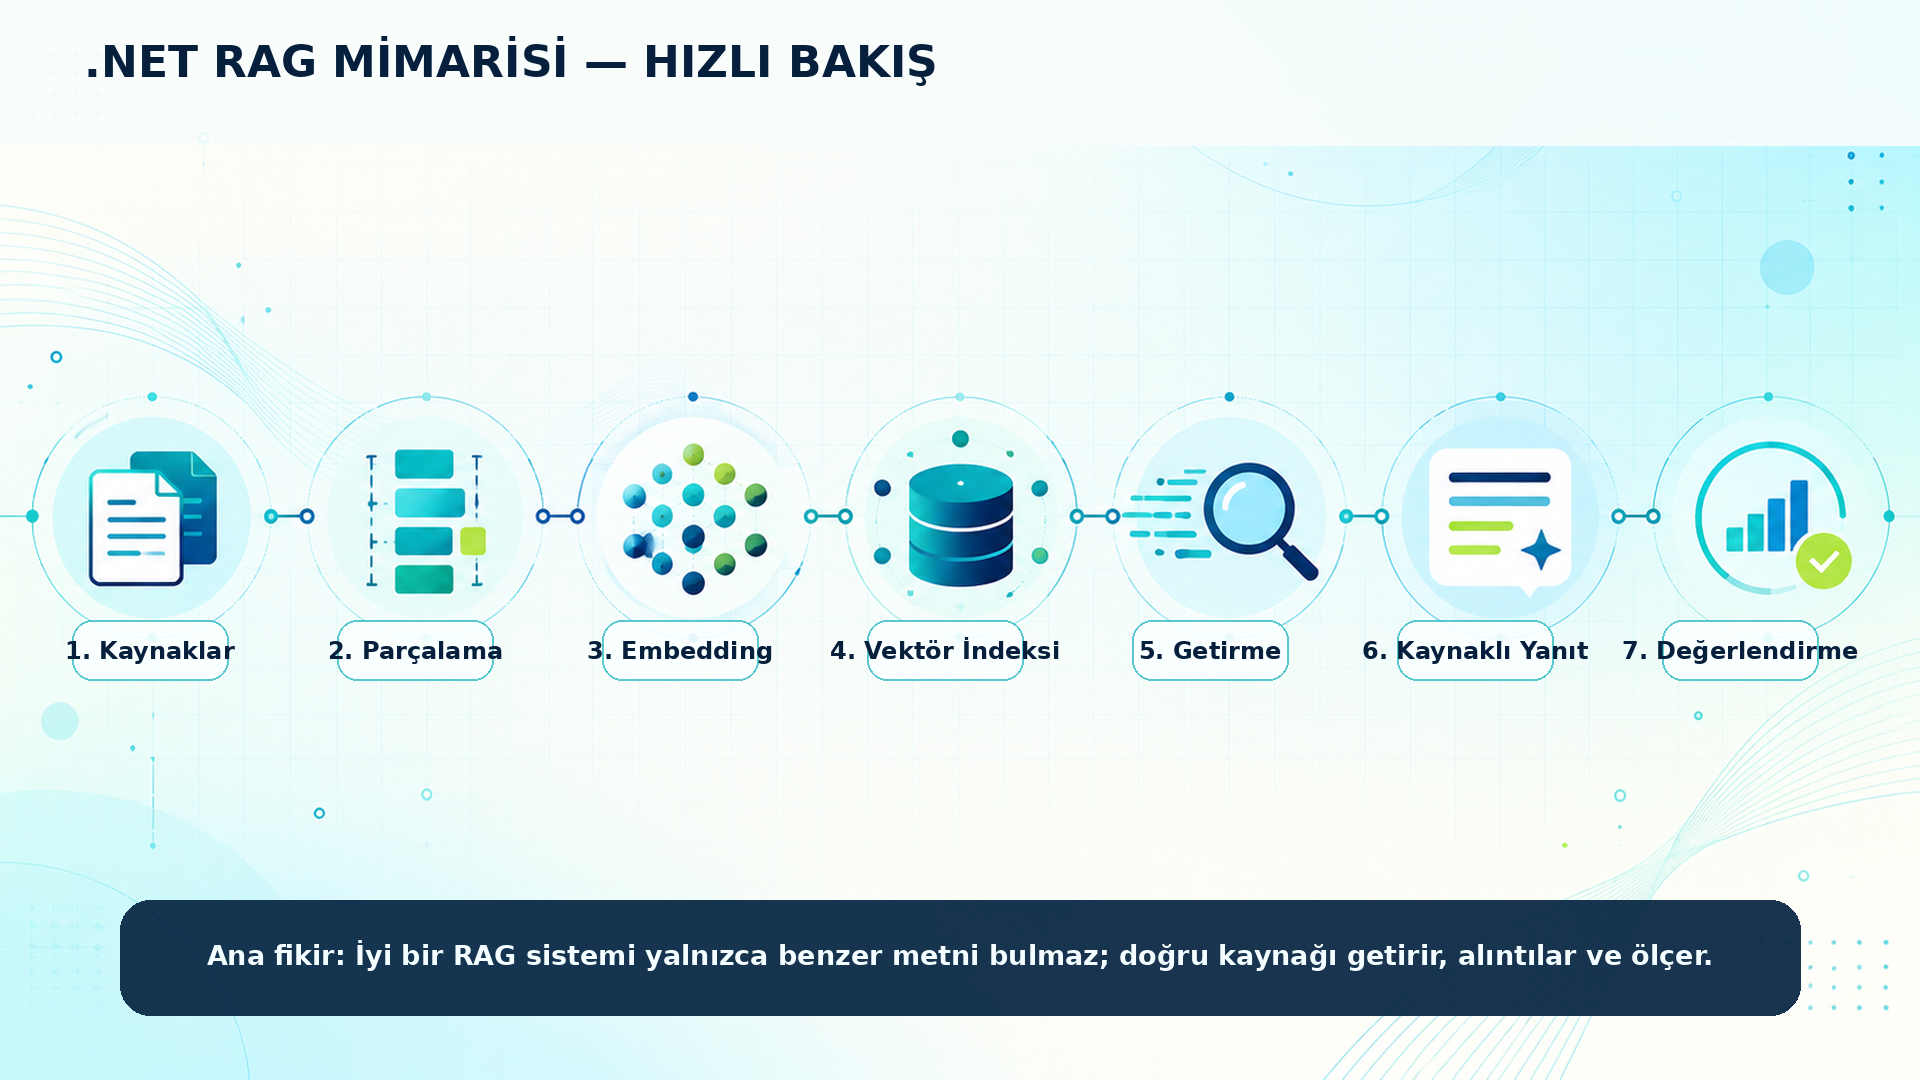
Bu rehber, .NET üzerinde sağlayıcıdan olabildiğince bağımsız bir RAG hattını yedi adımda ele alıyor. Hedef; güncellenebilir bilgi tabanı, izlenebilir kaynaklar, kontrollü maliyet ve tekrarlanabilir kalite ölçümü sunan bir yapı kurmak. Çalışan örnek proje önerisi de veri alımı, vektör arama, kaynak gösterme ve değerlendirme katmanlarını tek akışta somutlaştırır.
.NET ile kaynaklı ve ölçülebilir RAG akışını çalışan örnek üzerinden inceleyin.
GitHub Projesini İncele →İçindekiler
- 1. .NET RAG mimarisi için başarı ölçütünü tanımlayın
- 2. Veri alımını sürümlü ve tekrar çalıştırılabilir kurun
- 3. Parçalama stratejisini belgenin yapısına göre seçin
- 4. Embedding ve vektör indeksini değiştirilebilir tasarlayın
- 5. Getirme kalitesini hibrit arama ve yeniden sıralamayla artırın
- 6. Kaynaklı yanıt sözleşmesini modele açıkça verin
- 7. RAG değerlendirmesini CI sürecine bağlayın
- Sonuç
- Güvenilir Araştırma Kaynakları
1. .NET RAG mimarisi için başarı ölçütünü tanımlayın
İlk karar model veya vektör veritabanı değildir; sistemin hangi soruyu güvenilir biçimde cevaplayacağıdır. Destek dokümanı asistanı ile sözleşme analizi aynı hata toleransına sahip değildir. Bu nedenle kapsam, veri sahipliği, güncellik hedefi, erişim sınırları ve cevabın reddedilmesi gereken durumlar baştan yazılmalıdır.
Başarıyı yalnızca “cevap iyi görünüyor” şeklinde değerlendirmeyin. En az dört ölçü izleyin: doğru parçanın getirilme oranı, getirilen bağlamın soruyla ilgisi, cevabın bağlama bağlılığı ve kullanıcı sorusunu karşılama düzeyi. Yanıt süresi ile token maliyeti de kalite hedefinin yanına eklenmelidir. Böylece model veya indeks değişikliği yaptığınızda etkisini aynı veri kümesiyle karşılaştırabilirsiniz.
2. Veri alımını sürümlü ve tekrar çalıştırılabilir kurun
RAG hattının kalitesi çoğu zaman model çağrısından önce belirlenir. PDF, Word, HTML veya veri tabanı kayıtları önce düz metne çevrilir; başlık, bölüm, kaynak adresi, tenant, dil, güncelleme zamanı ve erişim etiketi gibi metaveriler korunur. Her belgeye kararlı bir kimlik ve içerik özeti vermek, değişmeyen dosyaların gereksiz yere yeniden işlenmesini önler.
Alım işlemi idempotent olmalıdır: aynı kaynak ikinci kez geldiğinde kopya üretmemeli, değişen kaynak eski parçaları güvenli biçimde yenilemelidir. Hatalı belgeyi tüm hattı durdurmak yerine karantinaya almak; ayrıştırma hatasını, sürümü ve tekrar deneme sonucunu kaydetmek işletimi kolaylaştırır. Bu yaklaşım, sitedeki Transactional Outbox rehberinde anlatılan güvenilir işleme zihniyetiyle uyumludur.
3. Parçalama stratejisini belgenin yapısına göre seçin
Sabit karakter sayısıyla kesmek kolaydır fakat başlık ile açıklamayı veya tablo satırlarını birbirinden koparabilir. Önce belgenin doğal sınırlarını kullanın: başlıklar, paragraflar, listeler, kod blokları ve tablo bölümleri. Ardından modelin bağlam penceresine ve sorgu tipine göre token tabanlı üst sınır uygulayın. Küçük bir örtüşme, sınırdaki anlamın kaybolmasını azaltabilir; aşırı örtüşme ise indeksi şişirir ve aynı bilgiyi tekrar tekrar getirir.
Her parça kendi kendine anlaşılır olmalı, ancak kaynağından kopmamalıdır. Başlık yolu, belge kimliği, sayfa veya bölüm konumu ve erişim etiketi parçayla birlikte saklanır. Kaynak metin değiştiğinde parça kimliğinin nasıl güncelleneceği de sözleşmenin parçasıdır. Bu metaveri daha sonra filtreleme, alıntı ve hata ayıklama için kritik hale gelir.
4. Embedding ve vektör indeksini değiştirilebilir tasarlayın
Embedding modeli metni sayısal bir gösterime dönüştürür; vektör indeksi de sorguya semantik olarak yakın parçaları bulur. Uygulama kodunu belirli bir sağlayıcının istemcisine doğrudan bağlamak yerine embedding üretimi ve vektör arama için arayüz kullanın. Microsoft.Extensions.AI ile Microsoft.Extensions.VectorData gibi .NET soyutlamaları, model veya depolama seçimini iş akışından ayırmaya yardımcı olur.
Vektör boyutu, uzaklık metriği ve embedding modeli birlikte sürümlenmelidir. Model değişince eski vektörlerle yeni sorgu vektörlerini karıştırmayın; yeni koleksiyonu arka planda doldurup kontrollü geçiş yapın. Ayrıca tenant, belge türü, dil ve erişim düzeyi filtrelerini vektör aramasından önce veya arama sırasında uygulayın. Benzerlik skoru, yetkilendirme kontrolünün yerine geçmez.
5. Getirme kalitesini hibrit arama ve yeniden sıralamayla artırın
Semantik arama kavramsal benzerliği yakalarken ürün kodu, hata numarası veya mevzuat maddesi gibi kesin terimlerde anahtar kelime araması daha güçlü olabilir. Hibrit arama iki sinyali birleştirir. İlk aşamada daha geniş aday kümesi alınabilir; ikinci aşamada daha pahalı bir yeniden sıralama modeli yalnızca bu adayları değerlendirir. Böylece doğruluk ile gecikme arasında daha kontrollü denge kurulur.
Sorgu başına alınan parça sayısını sabit bir sihirli sayı olarak görmeyin. Sorunun kapsamına, skor dağılımına ve bağlam bütçesine göre eşik uygulayın. Yeterli kanıt yoksa sistemin cevap üretmek yerine bunu açıkça söylemesi daha güvenlidir. Arama sorgusu, filtreler, seçilen parça kimlikleri, skorlar ve süreler loglandığında “model yanlış cevapladı” görünen birçok sorunun aslında getirme katmanından kaynaklandığı anlaşılır.
Ayrıca aynı sorunun farklı ifade biçimlerini test edin. Kısaltmalar, yazım hataları, eş anlamlılar ve çok dilli sorgular indeksin gerçek kullanım davranışını ortaya çıkarır. Sorgu yeniden yazma yararlı olabilir; ancak özgün kullanıcı niyetini kaybetmemek için hem ilk sorguyu hem dönüştürülmüş sorguyu iz kaydında saklayın.
6. Kaynaklı yanıt sözleşmesini modele açıkça verin
Modele gönderilen bağlam, güvenilir talimat değil veri olarak işaretlenmelidir. Sistem mesajı; yalnızca verilen kaynaklara dayanmayı, kaynakta bulunmayan bilgiyi uydurmamayı, çelişki varsa belirtmeyi ve her önemli iddiayı parça kimliğiyle ilişkilendirmeyi açıkça tarif etmelidir. Modelin serbest metin yerine cevap, kaynaklar ve yeterlilik durumu alanlarını içeren yapısal çıktı üretmesi, uygulama tarafındaki doğrulamayı kolaylaştırır.
Bu aşamada LLM Structured Outputs rehberi ile aynı prensip kullanılır: şema biçimi garanti edebilir, fakat içeriğin doğru olduğunu tek başına garanti etmez. Uygulama, dönen kaynak kimliklerinin gerçekten getirilen kümede bulunduğunu doğrulamalı; kullanıcıya başlık, bölüm ve gerçek bağlantı göstermelidir. Hassas veri içeren kaynaklar için MCP Server güvenliği yazısındaki minimum yetki ve veri minimizasyonu ilkeleri de geçerlidir.
7. RAG değerlendirmesini CI sürecine bağlayın
RAG sistemi prompt, model, embedding, parçalama veya indeks ayarı değiştiğinde sessizce gerileyebilir. Üretimden anonimleştirilmiş gerçek sorular ve uzmanlarca hazırlanmış beklenen kaynaklardan oluşan küçük ama temsilî bir altın veri kümesi oluşturun. Her değişiklikte retrieval recall, bağlam ilgisi, groundedness, cevap uygunluğu, kaynak doğruluğu, gecikme ve maliyet ölçümlerini yeniden çalıştırın.
Otomatik puanlayıcılar yararlıdır fakat tek başına yeterli değildir. Kritik senaryolarda insan incelemesi, reddetme davranışı, erişim ihlali testleri ve prompt injection denemeleri eklenmelidir. Eşik altındaki değişiklik CI sürecini durdurabilir; kabul edilen sonuçlar sürüm, model ve yapılandırma bilgileriyle saklanabilir. Bu disiplin, .NET RAG mimarisi için ölçülebilir bir kalite sözleşmesi oluşturur ve “hangi değişiklik cevabı bozdu?” sorusuna somut yanıt verir.
Sonuç
Üretim kalitesinde RAG; belge yükleme, embedding üretme ve sohbet ekranından daha fazlasıdır. Sürümlü veri alımı, anlamı koruyan parçalama, filtreli veya hibrit getirme, doğrulanabilir kaynak gösterimi ve sürekli değerlendirme aynı mimarinin parçalarıdır. Katmanlar arayüzlerle ayrıldığında model ya da vektör deposu değişse bile iş kuralları ve kalite kontrolleri korunur.
En doğru başlangıç, dar bir kullanım senaryosu ve ölçülebilir bir test kümesidir. Önce doğru kaynağı getirmeyi kanıtlayın; sonra yanıt üretimini, alıntıları ve operasyonel metrikleri ekleyin. Böylece demo etkisi yüksek ama güveni düşük bir sohbet uygulaması yerine, davranışı açıklanabilen ve zaman içinde geliştirilebilen bir bilgi sistemi kurabilirsiniz.