8 dk okuma
Giriş
ASP.NET Core Health Checks, bir container sürecinin yalnızca çalışıp çalışmadığını değil, trafik almaya gerçekten hazır olup olmadığını orkestratöre anlatan uygulama sözleşmesidir. Kubernetes yanlış sinyali doğru yorumlasa bile sonuç kötü olabilir: veritabanı kısa süreli yavaşladığında liveness başarısız olursa çalışan pod gereksiz yere yeniden başlatılır; uygulama açılışı tamamlanmadan readiness başarılı olursa kullanıcı trafiği hazırlıksız örneğe yönlenir.
Bu rehber liveness, readiness ve startup probe rollerini ayırır; ASP.NET Core endpoint tasarımından bağımlılık kontrollerine, zamanlama eşiklerinden kontrollü kapanış ve kesinti testlerine kadar yedi üretim kuralı sunar. Amaç her şeyi tek bir sağlık endpoint’ine doldurmak değil, platformun her durumda doğru aksiyonu seçmesini sağlayan hızlı, kararlı ve ölçülebilir sinyaller üretmektir.
Liveness, readiness ve startup probe davranışlarını çalışan ASP.NET Core örneğinde inceleyin.
GitHub Projesini İncele →İçindekiler
- Sağlık sözleşmesini operasyon kararıyla eşleştirin
- Liveness kontrolünü dış bağımlılıklardan ayırın
- Readiness ile trafik kabulünü yönetin
- Startup probe ile yavaş açılışı koruyun
- Bağımlılık kontrollerine süre ve kapsam bütçesi koyun
- Probe zamanlamasını gerçek ölçümlerle ayarlayın
- Dağıtım ve kesinti senaryolarını otomatik test edin
- Sonuç
- Güvenilir Araştırma Kaynakları
1. Sağlık Sözleşmesini Operasyon Kararıyla Eşleştirin
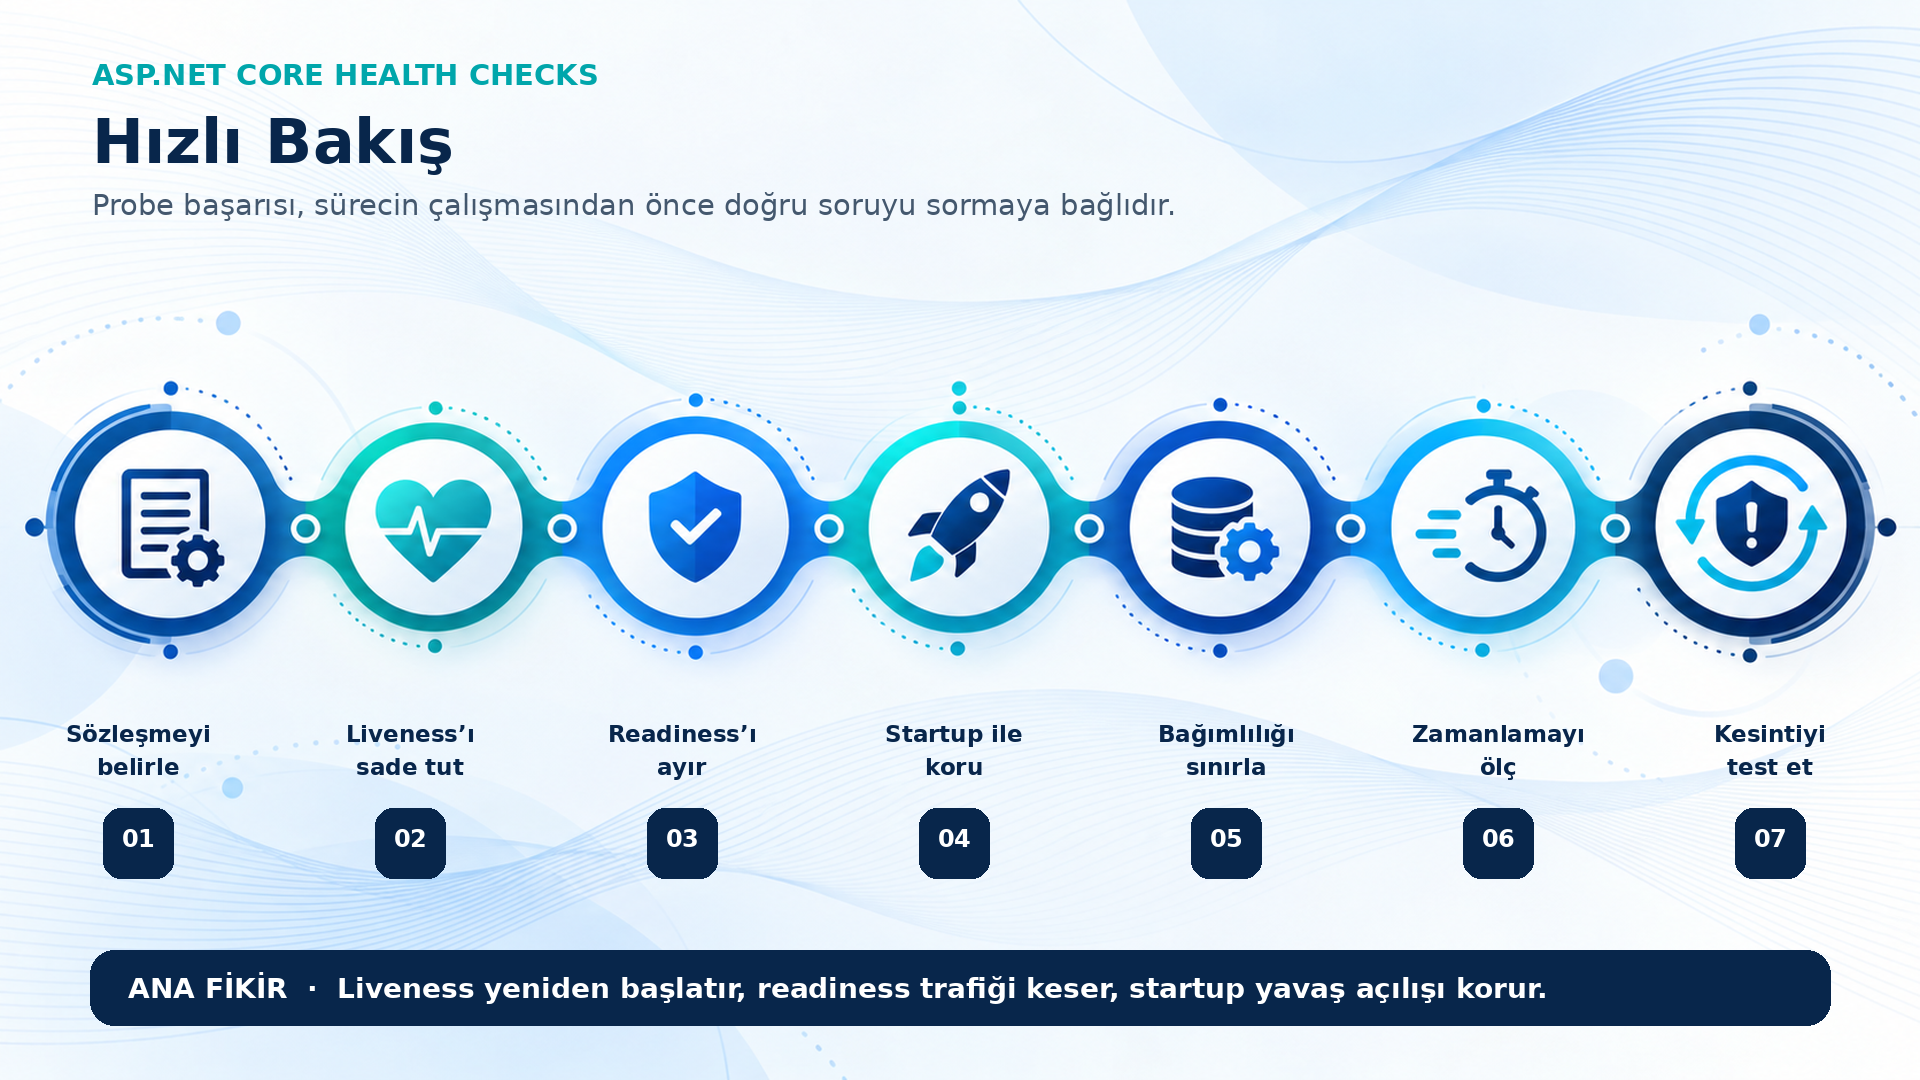
Her endpoint önce şu soruya cevap vermelidir: Bu sinyal başarısız olduğunda platform ne yapacak? Liveness başarısızlığı container’ın yeniden başlatılmasına, readiness başarısızlığı ise pod’un servis trafiğinden çıkarılmasına yol açar. Startup probe yalnız açılış aşamasında uygulamaya ek süre tanır. Aynı kontrol listesini üç endpoint’te tekrar etmek bu farklı kararları görünmez hale getirir.
Yanıt gövdesi insanlara tanılama bilgisi verebilir fakat HTTP durum kodu kararlı olmalıdır. Sağlıklı sonuç 200, trafiğe hazır olmayan durum 503 döndürebilir. Ayrıntılı hata mesajlarını herkese açık endpoint’te yayımlamayın; bileşen adları, bağlantı ayrıntıları veya istisna metinleri saldırı yüzeyi oluşturabilir.
2. Liveness Kontrolünü Dış Bağımlılıklardan Ayırın
Liveness’ın temel sorusu “süreç ilerleyebiliyor mu?” olmalıdır. Veritabanı, Redis veya üçüncü taraf API geçici olarak erişilemediğinde uygulamayı yeniden başlatmak çoğu zaman bağımlılığı düzeltmez; tersine bütün pod’lar aynı anda restart döngüsüne girebilir. Bu nedenle liveness kontrolünü uygulama içi deadlock, kritik background loop durumu veya süreç yaşam sinyali gibi yerel göstergelerle sınırlayın.
builder.Services.AddHealthChecks()
.AddCheck("self", () => HealthCheckResult.Healthy(), tags: ["live"])
.AddCheck<DatabaseHealthCheck>("database", tags: ["ready"]);
app.MapHealthChecks("/health/live", new()
{
Predicate = check => check.Tags.Contains("live")
});
Basit self kontrolü her problemi bulmaz, ancak liveness’ın platform aksiyonuyla uyumunu korur. Uygulama kendi kritik döngüsünün ilerleme zamanını izliyorsa belirli süre güncellenmeyen bir heartbeat gerçekten restart gerektiren yerel arızayı gösterebilir.
3. Readiness ile Trafik Kabulünü Yönetin
Readiness; uygulama ayakta olsa bile yeni istek kabul etmenin güvenli olup olmadığını belirtir. Başlangıç migration’ı, yapılandırma yükleme, cache ısınması veya zorunlu bağlantı kurulumu bitmeden pod hazır sayılmamalıdır. Çalışma sırasında kritik bir bağımlılık kısa süreli kullanılamazsa readiness trafiği başka sağlıklı örneklere yönlendirebilir.
Her bağımlılığı readiness’e eklemek de risklidir. Sadece belirli bir özellik için kullanılan yardımcı servis çöktüğünde bütün uygulamayı trafikten çıkarmak kapasiteyi gereksiz azaltabilir. Bağımlılıkları zorunlu, opsiyonel ve degrade çalışılabilir şeklinde sınıflandırın; readiness yalnız trafiği gerçekten güvensiz kılan koşulları içersin.
Readiness kapanış başlarken de false olmalıdır. Böylece yeni trafik kesilirken devam eden işler süre bütçesi içinde tamamlanabilir. Bu yaşam döngüsü, sitedeki .NET Worker Service kontrollü kapanış rehberi ile aynı platform sözleşmesinin diğer yarısıdır.
4. Startup Probe ile Yavaş Açılışı Koruyun
Yavaş açılan uygulamalarda liveness için çok büyük initialDelaySeconds vermek kaba bir çözümdür. Startup probe tanımlandığında Kubernetes bu kontrol başarıya ulaşana kadar liveness ve readiness çalıştırmaz. Böylece normal çalışma için sıkı liveness eşikleri korunurken ilk açılışta migration, model yükleme veya JIT ısınması için ayrı bütçe tanımlanır.
startupProbe:
httpGet: { path: /health/startup, port: 8080 }
periodSeconds: 5
failureThreshold: 24
livenessProbe:
httpGet: { path: /health/live, port: 8080 }
periodSeconds: 10
readinessProbe:
httpGet: { path: /health/ready, port: 8080 }
periodSeconds: 5
Startup bütçesi burada yaklaşık iki dakikadır. Değeri tahminle değil, soğuk başlangıç dağılımıyla belirleyin. Sürekli büyüyen açılış süresi ayrıca performans regresyonu olarak izlenmelidir; startup probe sorunu saklayan sınırsız bekleme alanına dönüşmemelidir.
5. Bağımlılık Kontrollerine Süre ve Kapsam Bütçesi Koyun
Sağlık endpoint’i kendisi yeni bir yük kaynağı olabilir. Her birkaç saniyede büyük tablo sorgulamak, dış servise gerçek işlem göndermek veya bütün cache’i taramak doğru değildir. Veritabanında düşük maliyetli bağlantı doğrulaması, mesajlaşma sisteminde kanal durumu ve dış API’de sağlayıcının önerdiği hafif endpoint tercih edilmelidir.
Her kontrol ayrı timeout taşımalı; toplam readiness yanıtı probe timeoutSeconds sınırından önce bitmelidir. Bir kontrolün gecikmesi bütün endpoint’i askıda bırakmamalıdır. Sonuçları çok kısa süre cache’lemek yüksek pod sayısında yükü azaltabilir, fakat cache süresi gerçek arızayı gereksiz geciktirmeyecek kadar kısa tutulmalıdır.
6. Probe Zamanlamasını Gerçek Ölçümlerle Ayarlayın
periodSeconds, timeoutSeconds, failureThreshold ve successThreshold birlikte bir karar penceresi oluşturur. Çok agresif eşikler kısa ağ dalgalanmasını arıza sayar; çok gevşek eşikler gerçek problemi uzun süre saklar. Readiness genellikle liveness’tan daha hızlı tepki verebilir, çünkü trafiği geçici kesmek restart’tan daha düşük etkili bir aksiyondur.
Örneğin 5 saniyelik periyot ve üç başarısızlık yaklaşık 15 saniyelik algılama penceresi üretir; ancak kontrol süresi ve zamanlama sapması da hesaba katılmalıdır. P95/P99 sağlık kontrolü süresini, başarısızlık nedenlerini, pod restart sayısını ve readiness geçişlerini metric olarak izleyin.
Health endpoint’lerini gereksiz telemetry gürültüsünden filtrelemek mümkün olsa da durum geçişlerini görünür tutmak gerekir. Trace ve metric yaklaşımını derinleştirmek için ASP.NET Core OpenTelemetry yazısı tamamlayıcıdır.
7. Dağıtım ve Kesinti Senaryolarını Otomatik Test Edin
Yerelde endpoint’e 200 döndüğünü görmek yeterli değildir. Soğuk başlangıç, veritabanı kesintisi, yavaş bağımlılık, SIGTERM, rolling deployment ve yanlış port senaryolarını aynı container image ile test edin. Beklenen davranış her senaryo için açık olmalıdır: pod restart mı olacak, yalnız trafikten mi çıkacak, yoksa degrade biçimde çalışmaya devam mı edecek?
Pipeline sonrasında ephemeral bir ortamda deployment ayağa kaldırıp startup ve readiness geçişlerini doğrulamak, YAML ile uygulama endpoint’i arasındaki uyumsuzluğu üretime ulaşmadan yakalar. Path, port, scheme ve timeout değerlerinin image ile aynı sürümde test edilmesi önemlidir.
Bu doğrulama aşaması, GitHub Actions ile .NET CI/CD rehberindeki deployment sonrası health check ve rollback yaklaşımını çalışma zamanı probe’larıyla tamamlar.
Sonuç
ASP.NET Core Health Checks için güvenilir tasarım, tek bir “healthy” endpoint üretmek değil; üç farklı platform kararına üç net sinyal vermektir. Liveness yalnız yeniden başlatmanın gerçekten çözebileceği yerel arızaları, readiness trafik kabulünü etkileyen zorunlu koşulları, startup ise açılışın tamamlanıp tamamlanmadığını göstermelidir.
Bağımlılık kontrollerini hafif tutun, her kontrole süre bütçesi koyun, probe eşiklerini gerçek ölçümlerle belirleyin ve kesinti davranışını deployment sürecinde otomatik doğrulayın. Böylece Kubernetes rastgele restart üreten bir gözetmen yerine, uygulamanın açıkça tanımladığı sağlık sözleşmesini uygulayan güvenilir bir operasyon katmanına dönüşür.