4 dk okuma
Giriş
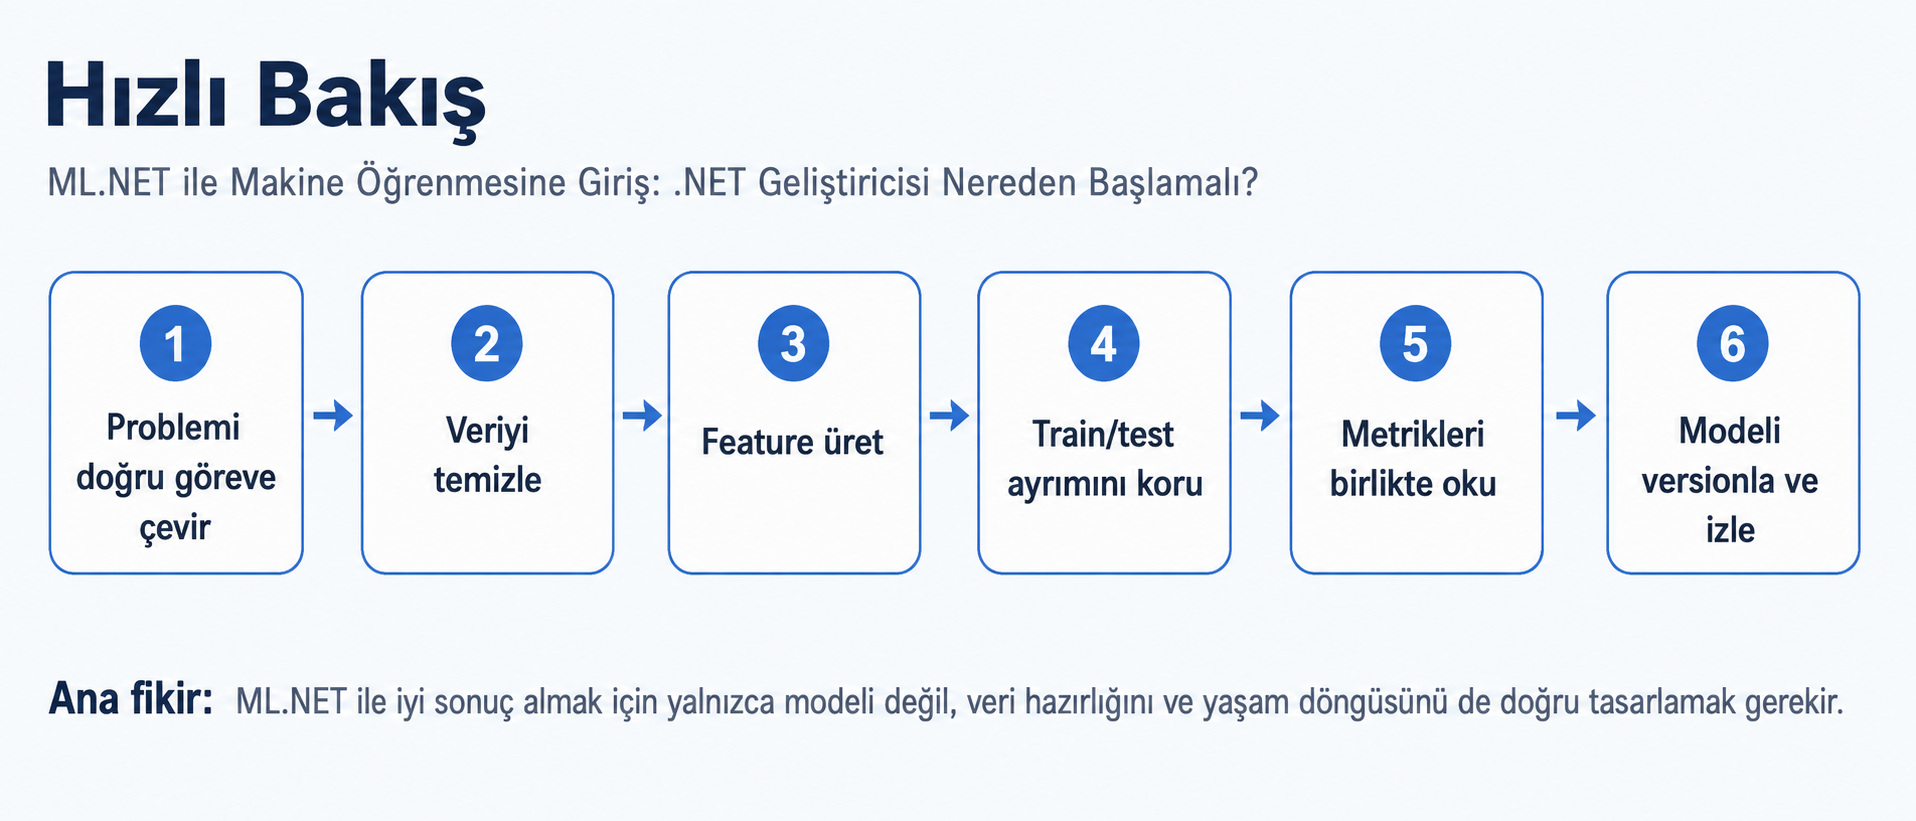
ML.NET ile makine öğrenmesi, C# ve .NET ekosisteminden çıkmadan regression, classification, anomaly detection, forecasting ve benzeri modeller geliştirmeyi mümkün kılıyor. Ancak başarılı bir makine öğrenmesi projesini belirleyen şey hangi trainer’ın seçildiğinden çok problemin doğru tanımlanması, verinin hazırlanması ve modelin gerçek hayatta ölçülmesidir. Bu nedenle ML.NET’e başlarken ilk hedef ‘model çalıştırmak’ değil, güvenilir bir eğitim ve değerlendirme hattı kurmak olmalıdır.
İlk soru: Hangi problemi çözüyoruz?
Tahmin edilecek değer sürekli bir sayıysa regression, iki veya daha fazla sınıftan biri seçilecekse classification, sıra dışı davranış aranıyorsa anomaly detection daha uygun görev olabilir. Finansal bir örnekte bir sonraki periyottaki beklenen yüzde değişimini tahmin etmek regression problemine; fiyatın belirli bir eşik üzerinde yükselip yükselmeyeceğini tahmin etmek binary classification problemine dönüşebilir. Aynı veri farklı hedeflerle farklı ML görevlerine çevrilebilir.
IDataView ve pipeline mantığı
ML.NET veri akışını IDataView üzerinden kurar. Ham veriyi yükledikten sonra eksik değer işlemleri, normalizasyon, kategorik dönüşümler ve feature birleştirme adımları bir pipeline içinde tanımlanır. Bu yaklaşımın en önemli avantajı, training sırasında yapılan veri dönüşümlerinin prediction sırasında da aynı sırayla uygulanabilmesidir.
Feature engineering neden modelden daha önemlidir?
Birçok gerçek dünya projesinde performansı belirleyen temel unsur algoritmadan çok feature setidir. Finansal veride ham fiyat yerine getiri, volatilite, momentum, hacim değişimi, trend gücü veya farklı periyotların oranları daha anlamlı olabilir. ERP tarafında ise müşteri geçmişi, sipariş frekansı ve sepet davranışı gibi iş açısından açıklanabilir feature’lar daha güçlü sonuç verir.
Train, validation ve test ayrımı
Rastgele split her veri setinde doğru değildir. Özellikle zaman serilerinde gelecekteki gözlemlerin training setine sızması modelin gerçekte sahip olmadığı bilgiyi kullanmasına neden olur. Bu yüzden kronolojik ayrım, rolling validation veya walk-forward yaklaşımı daha güvenlidir. Amaç modelin geçmişi ne kadar iyi ezberlediğini değil, görmediği gelecekte ne kadar genelleştiğini ölçmektir.
Metrikleri nasıl okumalıyız?
Regression tarafında RSquared tek başına yeterli değildir. MAE ve RMSE ile birlikte değerlendirmek hatanın gerçek büyüklüğünü daha iyi gösterir. Classification tarafında dengesiz veri varsa Accuracy yanıltıcı olabilir; precision, recall, F1 ve AUC gibi ölçümler birlikte okunmalıdır. Çok iyi görünen bir skor bazen data leakage işaretidir.
Modeli kaydetmek ve production kullanmak
Eğitim tamamlandığında modelin model.zip gibi versionlanabilir bir dosyada saklanması training ile inference süreçlerini ayırmayı kolaylaştırır. Production worker yalnızca onaylanmış modeli yükleyebilir; eğitim süreci ise belirli periyotlarda yeni model üretip metrikleri karşılaştırabilir. Model değişikliğinin kod deploy’una bağlı olmaması operasyonu ciddi biçimde kolaylaştırır.
Sonuç
ML.NET, .NET geliştiricisinin mevcut C# bilgisiyle makine öğrenmesine geçişini kolaylaştırıyor. Ancak başarılı sonuç için trainer seçmekten önce veri kalitesi, feature engineering, doğru validation ve production izleme disiplinini kurmak gerekir. İyi ML sistemi yalnızca tahmin yapan model değil, yeniden üretilebilir ve ölçülebilir bir mühendislik sürecidir.
Araştırma Kaynakları ve İleri Okuma
- Microsoft Learn – ML.NET overview – https://learn.microsoft.com/en-us/dotnet/machine-learning/
- Train and evaluate a model – https://learn.microsoft.com/en-us/dotnet/machine-learning/how-to-guides/train-machine-learning-model-ml-net
- Save and load models – https://learn.microsoft.com/en-us/dotnet/machine-learning/how-to-guides/save-load-machine-learning-models-ml-net